Qué hace el OCR
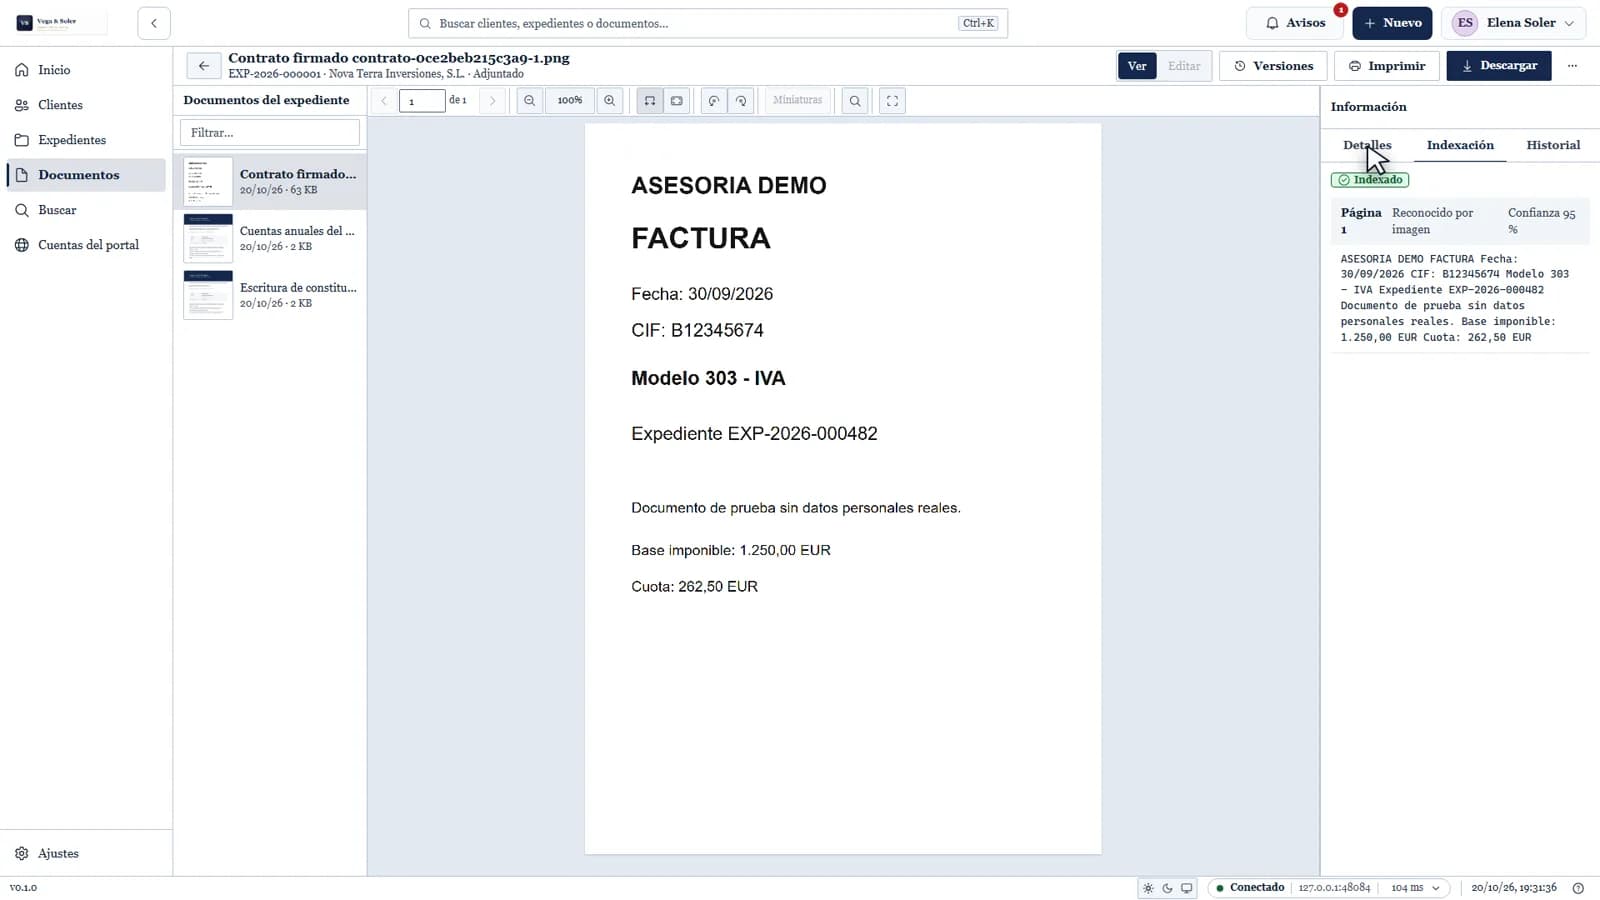
Un escáner o una foto producen una imagen. Esa imagen no contiene texto seleccionable: contiene píxeles. El OCR analiza la imagen, reconoce formas de letras y devuelve una secuencia de texto. Ese texto se puede indexar y buscar.
En un gestor documental, el OCR permite encontrar un contrato por una cláusula, una factura por un número o un certificado por un nombre, aunque el archivo se llamara «escaneado_001.pdf».
Qué no hace
El OCR no decide si el documento es correcto, no valida un NIF, no extrae importes con fiabilidad absoluta y no entiende el contexto jurídico. Puede confundir una «O» con un «0», una tilde o una firma. Por eso el texto reconocido es una ayuda de búsqueda, no una verdad automática.
Tampoco es lo mismo que la IA generativa. Un modelo de lenguaje puede resumir o extraer campos, pero el OCR es el paso previo: convertir la imagen en texto.
- No sustituye la revisión humana.
- No garantiza el 100 % de precisión en documentos mal escaneados.
- No convierte por sí solo un documento en una prueba legal.
Cuándo merece la pena
Merece la pena cuando el volumen de documentos hace imposible recordar nombres de archivo, cuando se busca por contenido y cuando el coste de no encontrar un documento es alto. También cuando el equipo dedica tiempo a abrir archivos uno a uno para comprobar un dato.
No merece la pena como sustituto de una buena clasificación. Si los documentos no tienen cliente, expediente y tipo, el OCR solo añade otra capa de texto sin contexto.
Buenas prácticas
Escanea a una resolución razonable, evita sombras y giros, usa PDF con texto cuando sea posible y revisa los documentos que vayas a usar para decisiones importantes. El OCR funciona mejor cuando la captura es buena.
- 300 DPI suele ser suficiente para documentos de oficina.
- Evita fotos inclinadas o con poca luz.
- Conserva el original aunque exista una versión con texto.